深度求索 · 智创未来
由 DeepSeek AI 倾力打造的通用推理与代码工程核心模型,通过开源开放范式重构算力与知识边界。从复杂问题推演到工业级工程落地,助力全球开发者与创作者深入探索未至之境。
超长上下文
原生支持 128K 超长上下文窗口,无论是百万字专业学术研报还是整套复杂系统源码,皆可精准检索并秒级理解全局脉络。
高效推理
纯强化学习(RL)算法大幅激发反思能力与链式推理(CoT),在极端数理、算法竞赛与复杂逻辑命题上表现拔尖。
开源开放
全权重无条件开源并遵循宽松商用协议,兼容主流推理引擎与量化框架,赋予开发者与企业极高的数据私密性与自由度。
红线区超频推理输出:DeepSeek R1纯强化学习推理实测 吞吐提升 320%
以车载抬头显示 HUD 为视觉骨架,将 Deep Seek 精准投影于决策视野中心。毫米级阳极氧化铝切削面板融合德劳内拓扑网格,实现人机协同的毫秒级反应与推理闭环。
为什么选择 DeepSeek AI
秉承「DeepSeek - 探索未至之境」的技术初心,在底层算法与工程架构双向突破,为全球开发者提供坚实可靠的基础模型底座。
极端算力与推理性能
借助 Multi-Head Latent Attention(MLA)架构与纯强化学习自驱算法,大幅削减显存占用,在单卡推理吞吐与极低延迟表现上树立全新标杆。
企业级数据与隐私安全
全方位支持本地大模型量化私有化部署。敏感数据与业务代码不出企业内网,遵循严格的安全对齐规范,杜绝越狱与敏感信息泄漏风险。
开箱即用的生态集成
DeepSeek api开放平台 100% 兼容 OpenAI SDK 接口规范。原项目仅需修改 Base URL 和 API Key 即可一键平滑迁移,无缝接入各类应用。
全领域高密度知识储备
预训练语料涵盖多万亿高质量多语言文本与开源代码库,在理工科研、金融风控、医学文献等严谨专业领域具备高准度语义把握能力。
自然流畅的多轮对话
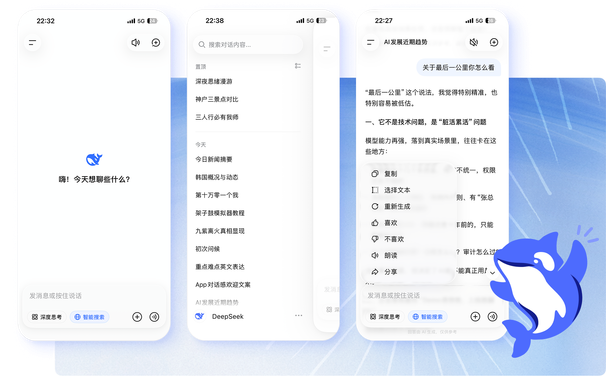
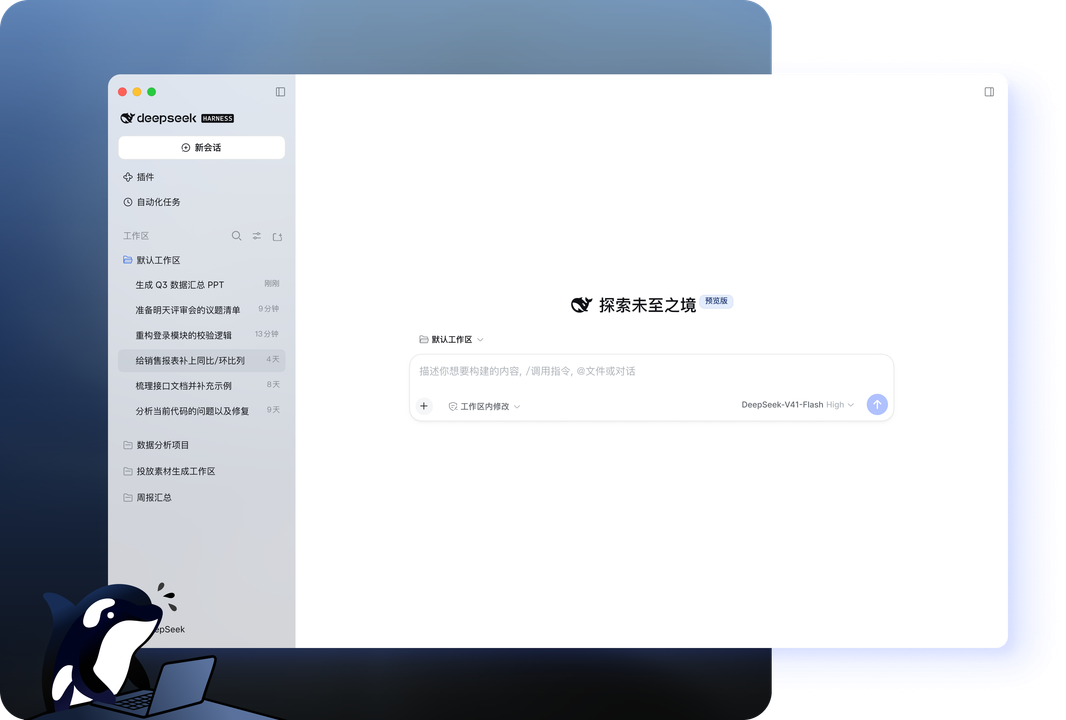
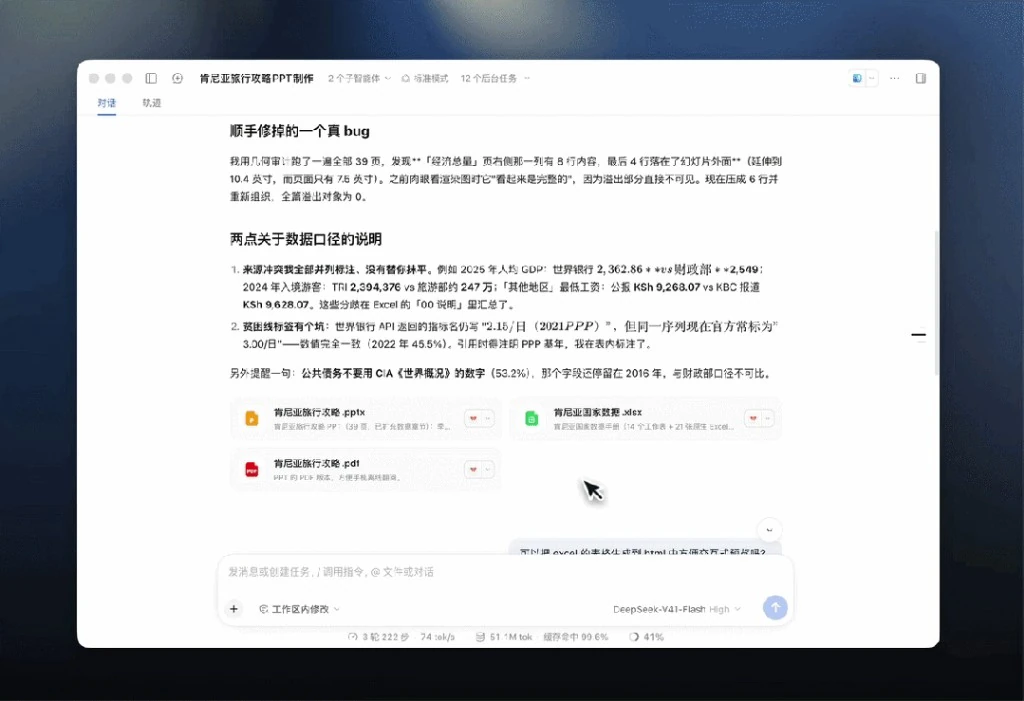
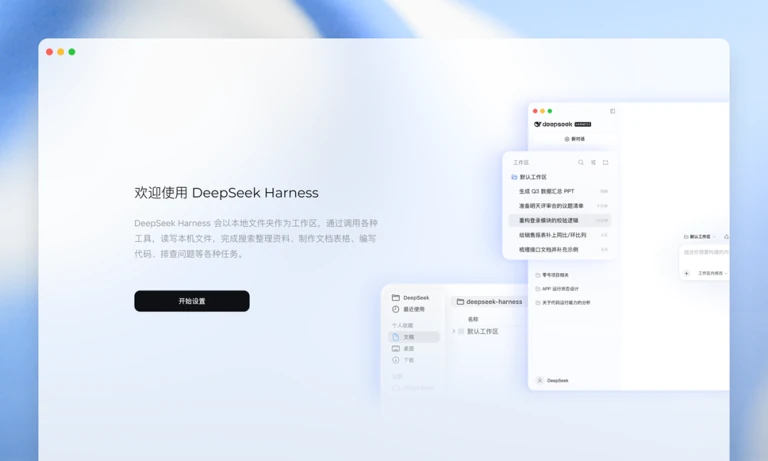
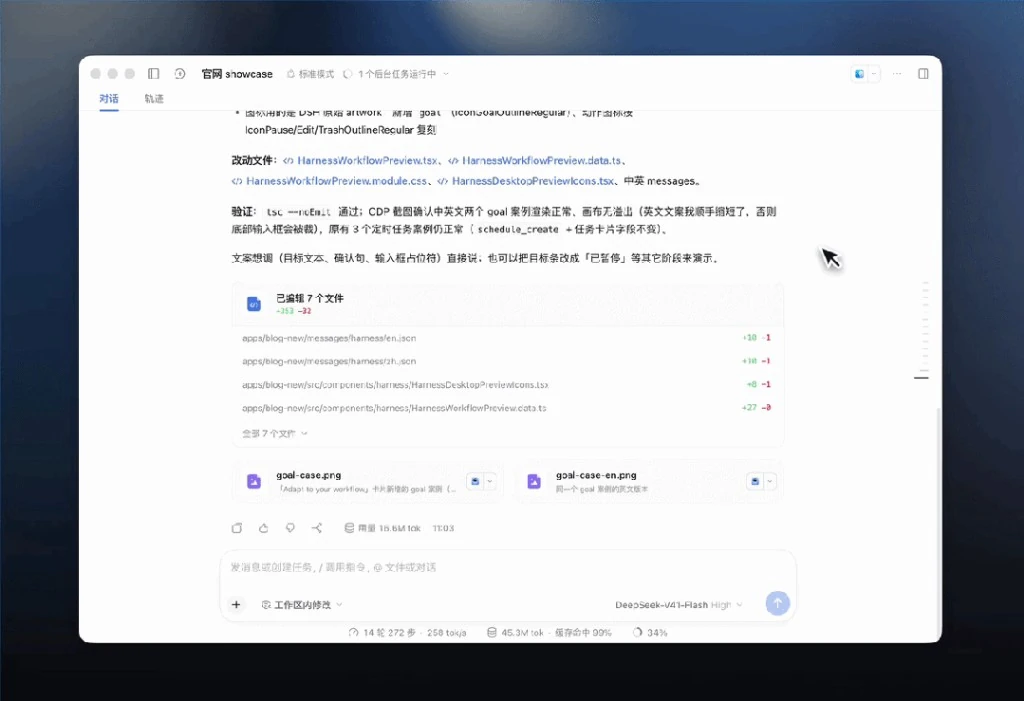
通过 DeepSeek网页版入口 即可免安装体验沉浸式对话工作台。支持自主长思维链推演展示,让 AI 的每一步思考都清晰可辨。
全球主流多语言互通
不仅在中英双语上表现登顶,对德、法、日、韩、西及几十种主流编程语言均保持高水平翻译与语法编译纠错,支撑跨国业务协同。
多样规格满足全场景需求
从旗舰超强综合模型到端侧轻量小钢炮,DeepSeek 模型家族为不同的业务算力预算与延迟要求提供最优解。
DeepSeek-V3
通用智能全能王,671B MoE 架构,激活仅 37B 参数。兼顾海量常识问答、长篇创意写作与复杂结构化数据解析。
- 上下文支持128K Token
- 训练数据14.8T Token
- 部署建议集群并发集群服务
DeepSeek-R1
纯强化学习突破之作,深度攻克复杂数理证明、算法解题与深度编程逻辑,自主展现反思与验证思维链。
- 数学跑分 MATH-50097.3% 超越顶尖
- 代码竞赛 Elo2029 顶尖排位
- 接入协议OpenAI 兼容 API
DeepSeek-R1-Distill
基于小尺寸模型精馏的高能版本(1.5B ~ 70B),适合消费级显卡、MacBook 本地端侧私有化离线运行。
- 显存门槛低至 4GB 显存
- 部署框架Ollama / vLLM / LM Studio
- 响应延迟毫秒级首字输出